
¿Cómo funciona el código genético y cuáles son sus características principales?
Descubre cómo funciona el código genético, su descubrimiento histórico, universalidad y su relación fundamental con la síntesis de proteínas.
En pocas palabras
- El código genético está compuesto por 64 codones formados a partir de tripletes de nucleótidos.
- Existen 61 codones que especifican aminoácidos y 3 que actúan como señales de parada.
- Marshall Warren Nirenberg y Heinrich J. Matthaei descubrieron la primera correspondencia codón-aminoácido en 1961.
¿Cómo funciona el código genético y cuáles son sus características principales?
El código genético representa el sistema de reglas mediante el cual las células traducen la información almacenada en el material genético hacia la estructura de las proteínas. Este mecanismo opera fundamentalmente interpretando secuencias de nucleótidos para ensamblar cadenas de aminoácidos esenciales para la vida.
¿Qué es exactamente un codón y cómo determina la secuencia de proteínas?
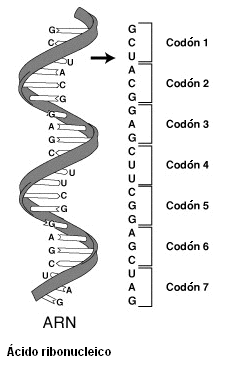
Un codón es una secuencia de tres nucleótidos consecutivos en el ARN mensajero que especifica un aminoácido determinado o indica una señal de parada durante la síntesis de proteínas. Las cuatro bases nitrogenadas presentes en los ácidos nucleicos —adenina, guanina, citosina y timina o uracilo— se combinan en tripletes, lo que genera un total de 64 codones posibles. De estos, 61 codifican aminoácidos específicos, mientras que tres actúan como señales de terminación para finalizar la cadena polipeptídica.
¿Cómo se descubrió el código genético y quiénes fueron los científicos clave?
El desciframiento del código genético requirió una serie de descubrimientos fundamentales realizados durante las décadas de 1950 y 1960. George Gamow propuso inicialmente que el código estaba formado por tripletes de bases. Posteriormente, en 1961, Marshall Warren Nirenberg y Heinrich J. Matthaei lograron la primera correspondencia empírica al traducir ARN de poli-uracilo y demostrar que el codón UUU codifica la fenilalanina. Investigadores como Severo Ochoa, Har Gobind Khorana y Robert W. Holley completaron las correspondencias de los codones y esclarecieron el papel adaptador del ARN de transferencia, contribuyendo a que Khorana, Holley y Nirenberg recibieran el Premio Nobel en Fisiología o Medicina en 1968.
¿Por qué se considera que el código genético es universal?
La universalidad del código genético se manifiesta en que prácticamente todos los organismos conocidos, desde las bacterias hasta los eucariotas superiores y los virus, utilizan las mismas reglas de correspondencia entre codones y aminoácidos. Esta uniformidad fundamental constituye una de las pruebas más sólidas de que toda la vida en la Tierra comparte un origen evolutivo único. No obstante, la investigación molecular ha revelado excepciones menores en ciertos orgánulos celulares, como las mitocondrias, donde se observan pequeñas variaciones en el significado de algunos codones.
¿Qué significa que el código genético sea degenerado pero no ambiguo?
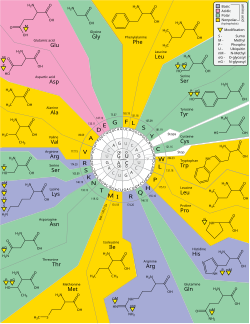
La degeneración del código genético significa que un mismo aminoácido puede estar codificado por múltiples codones diferentes, lo que aporta una redundancia beneficiosa que mitiga los efectos de posibles mutaciones puntuales. Sin embargo, el código carece de ambigüedad, lo que implica que un codón específico jamás codifica más de un aminoácido distinto. Esta precisión asegura que la información transmitida desde el ADN se traduzca de forma coherente en la maquinaria celular sin alterar la identidad de la proteína resultante.
¿Cómo contribuye la estructura del código a la minimización de errores por mutaciones?
La distribución de los codones dentro del código genético no es aleatoria, sino que muestra una organización que minimiza el impacto biológico de las alteraciones genéticas. Los aminoácidos con propiedades químicas o hidropatías similares suelen compartir bases comunes en sus codones, de modo que un cambio en un único nucleótido a menudo resulta en una mutación silenciosa o en la sustitución por un aminoácido de características equivalentes, preservando en gran medida la funcionalidad de la proteína.
Sources & Further Reading
Yılmaz, İrfan (2014). Evolución. Işık Yayıncılık Ticaret.
Aird, Kishori (2007). El ADN y la elección cuántica. Vesica Piscis.
Ondarza, N. (1994). Biología Molecular: Antes y después de la doble Hélice. Siglo XXI.
Aldridge, Susan (1999). El hilo de la vida: De los genes a la ingeniería genética. Ediciones AKAL.
Tu voto se guarda en este dispositivo.