
¿Qué es la bioinformática y cómo transforma el análisis de datos biológicos?
Descubra qué es la bioinformática, su historia, principales áreas de investigación como el análisis de secuencias y el impacto de las herramientas computacionales en la biología moderna.
En pocas palabras
- La bioinformática aplica tecnologías computacionales y estadística para la gestión y análisis de datos biológicos a escala molecular.
- El algoritmo Needleman-Wunsch, publicado en 1970, marcó un hito fundamental en el alineamiento computacional de secuencias.
- El Proyecto Genoma Humano, completado en 2003, impulsó de forma decisiva el desarrollo de bases de datos y algoritmos bioinformáticos avanzados.
¿Qué es la bioinformática y cómo transforma el análisis de datos biológicos?
En este artículo exploraremos la definición, evolución histórica y principales áreas de aplicación de la bioinformática, comprendiendo cómo las herramientas computacionales permiten gestionar y analizar grandes volúmenes de datos biológicos a escala molecular.
¿Cómo se define la bioinformática y qué relación guarda con la biología computacional?
La bioinformática puede definirse de manera general como la aplicación de tecnologías computacionales y la estadística a la gestión y análisis de datos biológicos. Los términos bioinformática, biología computacional e informática biológica se utilizan con frecuencia como sinónimos en la literatura básica; sin embargo, instituciones como los Institutos Nacionales de la Salud de los Estados Unidos (NIH) establecen matices diferenciales. La bioinformática se centra en la investigación, desarrollo o aplicación de herramientas computacionales para la adquisición, almacenamiento, organización, análisis y visualización de datos biológicos y médicos. Por su parte, la biología computacional abarca el desarrollo y aplicación de métodos teóricos, modelado matemático y técnicas de simulación computacional para el estudio de sistemas biológicos. Ambas disciplinas requieren el uso coordinado de ciencias de la computación, matemáticas aplicadas, estadística, química y bioquímica para resolver problemas que sobrepasan el discernimiento humano a nivel molecular.
¿Cuáles fueron los hitos históricos fundamentales en el desarrollo de la disciplina?
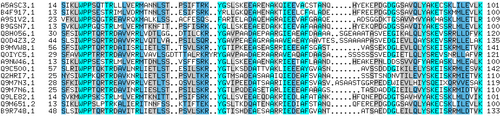
El desarrollo de la bioinformática está estrechamente vinculado a grandes avances científicos y tecnológicos ocurridos a partir de la segunda mitad del siglo XX. En la década de 1950 se propuso la estructura de doble hélice del ADN por Watson y Crick en 1953 y se secuenció la primera proteína, la insulina bovina, por F. Sanger en 1955. Durante los años 60, Margaret Dayhoff publicó el primer Atlas of Protein Sequences, obra precursora de las actuales bases de datos de proteínas. Las décadas siguientes presenciaron la aparición de algoritmos pioneros como el algoritmo Needleman-Wunsch en 1970 y el algoritmo Smith-Waterman en 1981, diseñados para el alineamiento de secuencias biológicas. Asimismo, la creación de bases de datos como GenBank en 1982 y Swiss-Prot en 1986, junto con el lanzamiento del Proyecto Genoma Humano a finales de los años 80 y principios de los 90, consolidaron definitivamente la infraestructura analítica de la bioinformática moderna.
¿Por qué es fundamental el análisis de secuencias en la investigación actual?
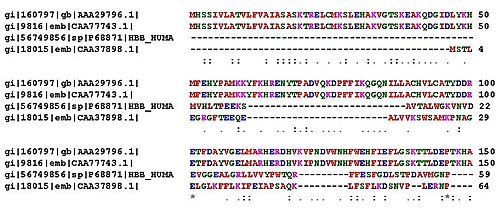
El análisis de secuencias es una de las herramientas básicas e indispensables de la bioinformática. Desde la secuenciación del fago Φ-X174 en 1977, las secuencias de ADN de cientos de organismos se han decodificado y almacenado en repositorios digitales masivos. Estos datos se analizan mediante programas computacionales avanzados para identificar genes que codifican proteínas específicas, predecir estructuras y estudiar relaciones filogenéticas entre especies. Con técnicas modernas de secuenciación a gran escala, como la secuenciación de tipo shotgun o por perdigonada, se obtienen miles de fragmentos cortos de ADN que posteriormente deben ser ensamblados computacionalmente para reconstruir los genomas completos. Este ensamblaje de alta calidad requiere complejos algoritmos capaces de gestionar grandes volúmenes de datos y compensar posibles errores o mutaciones.
¿Cómo contribuye la bioinformática a la predicción de estructuras de proteínas?
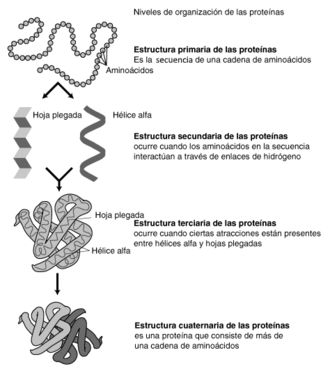
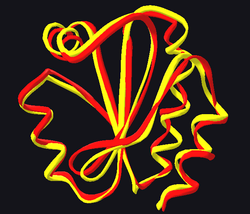
La predicción de la estructura tridimensional de las proteínas a partir de su secuencia de aminoácidos constituye una de las áreas de mayor relevancia y complejidad en la biología computacional. Aunque la estructura primaria determina la conformación nativa de la proteína en su entorno, la predicción estructural general sigue siendo un problema abierto que se aborda mediante aproximaciones heurísticas y comparativas. Un concepto central en este ámbito es la homología; si la secuencia de una proteína con función conocida comparte similitudes estructurales o evolutivas con otra de función desconocida, es posible inferir su estructura y comportamiento mediante técnicas como el modelado por homología. Estas investigaciones son esenciales para comprender los mecanismos moleculares y las interacciones entre biomoléculas en los organismos vivos.
¿Qué papel desempeñan las herramientas de software libre y los servicios web?
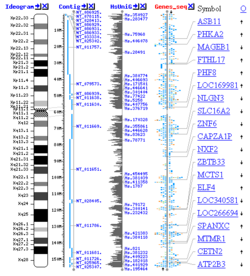
El desarrollo de la bioinformática se sustenta en una amplia comunidad de software libre y recursos accesibles en línea que facilitan la colaboración científica internacional. Desde la década de 1980, investigadores de todo el mundo han contribuido con herramientas de código abierto como BLAST para la búsqueda de similitudes en bases de datos, ClustalW para alineamientos múltiples de secuencias, y paquetes especializados integrados en plataformas como Bioconductor, BioPerl y Biopython. Adicionalmente, la implementación de servicios web basados en arquitecturas SOAP y REST permite a los científicos ejecutar algoritmos complejos y consultar bases de datos distribuidas globalmente sin necesidad de mantener infraestructuras locales masivas, garantizando la reproducibilidad y la actualización continua de los protocolos analíticos.
Sources & Further Reading
- European Bioinformatics Institute. (2006). What is Bioinformatics? Disponible en: http://www.ebi.ac.uk/2can/bioinformatics/bioinf_what_1.html
- Lander, Eric S.; Waterman, Michael S. (1995). Calculating the Secrets of Life: Contributions of the Mathematical Sciences to Molecular Biology. National Academy Press. ISBN: 0-309-07502-5.
- Mount, David W. (2004). Bioinformatics: Sequence and Genome Analysis. Cold Spring Harbor Laboratory Press. ISBN: 0-87969-712-1.
- Gauthier, Jeff; Vincent, Antony T.; Charette, Steve J.; Derome, Nicolas. (2019). A brief history of bioinformatics. Briefings in Bioinformatics, 20(6), 1981–1996. DOI: 10.1093/bib/bby063.
Tu voto se guarda en este dispositivo.