¿Qué es la biología computacional y cuáles son sus áreas de estudio?
Descubre en qué consiste la biología computacional, sus subcampos principales como la bioinformática y la biología de sistemas, y su impacto en la investigación.
En pocas palabras
- La biología computacional utiliza algoritmos y modelos matemáticos para estudiar sistemas biológicos desde el nivel molecular hasta los ecosistemas.
- El NIH diferencia formalmente la bioinformática, centrada en herramientas y gestión de datos, de la biología computacional, orientada al estudio teórico de sistemas biológicos.
- El Proyecto Genoma Humano y el Consorcio Telomere-to-Telomere (T2T) representan hitos monumentales apoyados en el análisis genómico computacional.
- El uso de software de código abierto garantiza la reproducibilidad y la transparencia en la investigación científica según directrices de publicaciones como PLOS Computational Biology.
¿Qué es la biología computacional y cuáles son sus áreas de estudio?
La biología computacional es una disciplina científica que emplea algoritmos informáticos, modelos matemáticos y simulaciones computacionales para analizar y comprender sistemas biológicos complejos. A diferencia de las metodologías tradicionales estrictamente experimentales, este campo aborda problemas que van desde la escala molecular hasta ecosistemas enteros, integrando conocimientos de la informática, las matemáticas aplicadas, la estadística y las ciencias de la vida.
¿Cómo se diferencia la biología computacional de la bioinformática?
La relación entre la biología computacional y la bioinformática ha sido objeto de debate institucional, aunque a menudo se utilizan de manera intercambiable. El Instituto Nacional de Salud de Estados Unidos (NIH) establece una distinción basada en el enfoque metodológico y el objetivo principal de cada disciplina. La bioinformática se orienta primordialmente hacia el desarrollo de herramientas informáticas, la gestión de bases de datos y el procesamiento de grandes volúmenes de datos biológicos. Por su parte, la biología computacional utiliza esos recursos y algoritmos para formular hipótesis y estudiar directamente los principios fundamentales de los sistemas biológicos.
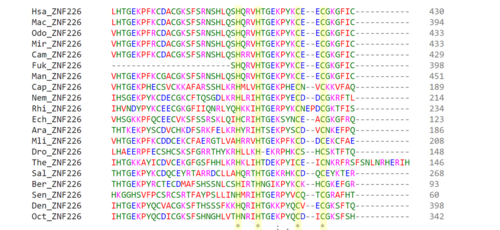
En la práctica cotidiana de la investigación, estas fronteras suelen difuminarse, ya que los científicos de ambas áreas comparten métodos computacionales, técnicas de aprendizaje automático y lenguajes de programación para resolver problemas complejos de alineamiento de secuencias, anotación genómica y modelado de interacciones moleculares.
¿Qué papel desempeña el análisis de secuencias en la investigación actual?
El análisis de secuencias comprende la identificación de bases nucleotídicas, la búsqueda de patrones repetitivos y la detección de elementos genómicos funcionales como genes codificantes de proteínas, regiones promotoras y sitios de unión para factores de transcripción. Estas tareas son fundamentales para descifrar las instrucciones codificadas en el ADN y comprender su repercusión estructural y funcional en los organismos vivos. Para llevar a cabo estos análisis, los investigadores se apoyan en bases de datos especializadas como GenBank, Ensembl y RefSeq, además de herramientas algorítmicas de referencia mundial como BLAST y FastA para la comparación rápida de secuencias biológicas.
¿En qué consiste la biología de sistemas y cuál es su enfoque holístico?
La biología de sistemas representa un cambio paradigmático frente al reduccionismo histórico, ya que aborda el estudio de los procesos biológicos desde una perspectiva integradora y holística. En lugar de analizar componentes aislados, este campo examina las interacciones complejas entre genes, proteínas, metabolitos y vías de señalización intracelular para comprender las propiedades emergentes de los sistemas vivos.
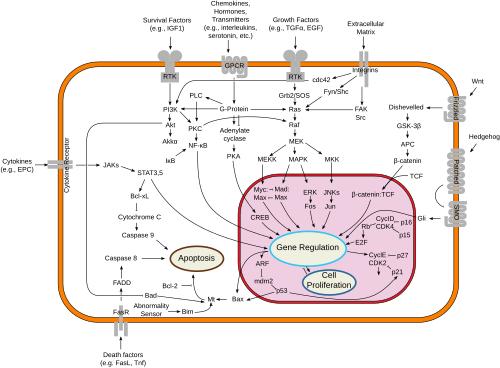
Mediante el modelado matemático de redes metabólicas, como la glucólisis, y el análisis de balance de flujo, los científicos pueden simular el comportamiento celular bajo diversas condiciones ambientales o patológicas. Esta aproximación cuantitativa permite predecir fenotipos celulares y comprender de manera integral la respuesta de los organismos ante estímulos externos o alteraciones moleculares.
¿Cómo ha transformado la genómica computacional el estudio de los genomas?
La genómica computacional aplica métodos estadísticos y algorítmicos para descifrar la información contenida en las secuencias de ADN y ARN. Desde el desarrollo inicial de algoritmos de alineamiento clásico hasta la implementación de tecnologías de secuenciación de nueva generación (NGS), este subcampo ha sido el motor detrás de grandes hitos históricos. El ejemplo más destacado es el Proyecto Genoma Humano, culminado en su primera fase en el año 2003, y los avances posteriores del Consorcio Telomere-to-Telomere (T2T), que en 2022 publicaron la secuencia completa y sin huecos del genoma humano de referencia.
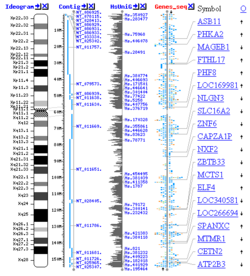
Asimismo, iniciativas globales como el Proyecto 1000 Genomas y el Earth BioGenome Project dependen críticamente de potentes infraestructuras computacionales para procesar petabytes de datos genéticos, identificar variantes estructurales y estudiar la biodiversidad de los organismos eucariotas en la Tierra.
¿Por qué es importante el uso de software de código abierto en esta disciplina?
El desarrollo y la utilización de herramientas de código abierto constituyen un pilar fundamental para la comunidad de biología computacional. Revistas especializadas como PLOS Computational Biology destacan cuatro ventajas principales de este modelo en la investigación científica: la reproducibilidad exacta de los análisis por parte de terceros, un desarrollo tecnológico más rápido al evitar la duplicación de esfuerzos, una mayor calidad mediante la revisión colectiva del código y la disponibilidad a largo plazo de las aplicaciones sin restricciones comerciales o patentes privativas.
Sources & Further Reading
- Huerta, M., Haseltine, F., Liu Y., Downing, G. & Seto B. (2000). NIH working definition of Bioinformatics and Computational Biology. web.archive.org.
- Korf, Ian (2004). Gene finding in novel genomes. BMC Bioinformatics, 5, 59.
- Nurk, Sergey et al. (2022). The complete sequence of a human genome. Science, 376(6588), 44-53.
- Lewin, H. A. et al. (2018). Earth BioGenome Project: Sequencing life for the future of life. Proceedings of the National Academy of Sciences, 115(17), 4325-4333.
Tu voto se guarda en este dispositivo.