
¿Qué es una araña web y cómo funciona en el ecosistema digital?
Descubre qué es una araña web, cómo indexa el contenido de internet y cuáles son las políticas que rigen su comportamiento en la red.
En pocas palabras
- Las arañas web utilizan una lista de semillas iniciales para comenzar el proceso de descubrimiento de enlaces.
- El protocolo robots.txt es el estándar principal para que los administradores de sitios web gestionen el acceso de los rastreadores.
- La política de revisita busca equilibrar la frescura del contenido con los recursos limitados de red y servidor.
- El rastreo de la web profunda requiere técnicas especializadas, como el uso de Sitemaps o la interacción con formularios web.
¿Qué es una araña web y cómo funciona en el ecosistema digital?
Una araña web, también conocida como rastreador o indexador, es un programa informático diseñado para inspeccionar páginas de la World Wide Web de manera metódica y automatizada. Su función principal es recopilar información para que los motores de búsqueda puedan indexar el contenido, permitiendo así que los usuarios realicen consultas rápidas y precisas.
¿Cómo inicia y desarrolla su proceso de rastreo una araña web?
El proceso comienza con una lista de direcciones URL predefinidas, conocidas como semillas. A medida que el programa visita estas direcciones, identifica todos los hipervínculos presentes en las páginas y los añade a una lista dinámica denominada frontera de rastreo. Este ciclo se repite de forma recursiva siguiendo un conjunto de políticas preestablecidas.
¿Qué políticas determinan el comportamiento de un rastreador?
El comportamiento de una araña web está definido por cuatro políticas fundamentales: la de selección, que decide qué páginas descargar; la de revisita, que determina cuándo verificar cambios; la de cortesía, diseñada para evitar la sobrecarga de servidores; y la de paralelización, que coordina múltiples procesos simultáneos.
¿Por qué es crucial la política de cortesía para los administradores de sitios?
Debido a que las arañas pueden realizar peticiones a una velocidad muy superior a la humana, corren el riesgo de colapsar servidores o routers. El estándar de exclusión de robots, implementado mediante el archivo robots.txt, permite a los administradores indicar qué partes del sitio no deben ser accedidas, protegiendo así los recursos de red y la estabilidad del servidor.
¿Cómo se mide la frescura y la novedad del contenido rastreado?
Los motores de búsqueda utilizan métricas de novedad y antigüedad para evaluar si la copia local de una página sigue siendo válida. La novedad es una medida binaria que verifica si el contenido ha cambiado, mientras que la antigüedad calcula el tiempo transcurrido desde la última modificación, ayudando al rastreador a decidir cuándo es necesario volver a visitar un recurso.


¿Qué desafíos presenta el rastreo de la web profunda?
La web profunda contiene páginas que no son accesibles mediante enlaces directos, sino que requieren consultas a bases de datos. Para abordar este contenido, los rastreadores utilizan protocolos como Sitemaps o técnicas de screen scraping, que permiten interactuar con formularios web para extraer datos que de otro modo permanecerían ocultos para los motores de búsqueda convencionales.
¿Cómo se estructura la arquitectura de un rastreador de alto rendimiento?
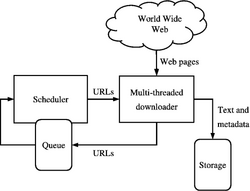
Construir un sistema capaz de descargar cientos de millones de páginas requiere una arquitectura altamente optimizada que gestione eficientemente la entrada/salida y la red. Estos sistemas suelen integrar un servidor de URLs que distribuye tareas entre múltiples procesos, asegurando que el rastreo sea escalable y robusto frente a la inmensidad de la web.
Sources & Further Reading
- Cho, Junghoo (2001). Crawling the Web: Discovery and Maintenance of a Large-Scale Web Data. Stanford University.
- Brin, Sergey; Page, Lawrence (1998). The anatomy of a large-scale hypertextual Web search engine. Computer Networks and ISDN Systems.
- Koster, M. (1996). A standard for robot exclusion. Robotstxt.org.
- Shkapenyuk, V.; Suel, T. (2002). Design and implementation of a high performance distributed web crawler. IEEE CS Press.
Tu voto se guarda en este dispositivo.