¿Qué es una población estadística y cómo se utiliza en la investigación?
Descubre qué es una población estadística, cómo se diferencia de una muestra y su papel fundamental en la inferencia y el análisis de datos científicos.
En pocas palabras
- La población estadística es el conjunto completo de elementos de interés para un experimento o estudio.
- La muestra es un subconjunto de la población utilizado para realizar inferencias estadísticas.
- La media poblacional (μ) es un parámetro de tendencia central que representa el valor esperado de una distribución.
- Las subpoblaciones son grupos dentro de una población que comparten características específicas y pueden requerir análisis separados.
- El sesgo en la investigación suele ocurrir cuando la población de muestreo no coincide con la población objetivo.
¿Qué es una población estadística y cómo se utiliza en la investigación?
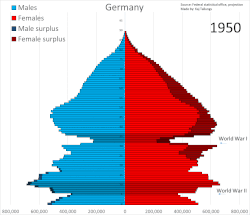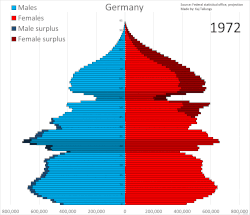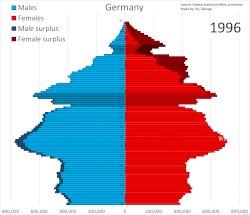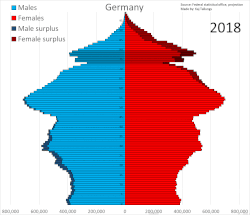
En estadística, una población es el conjunto completo de elementos, individuos o eventos que comparten una característica común y que son objeto de estudio. Este concepto es la base sobre la cual se construye cualquier análisis, ya que representa el grupo total del cual se desea obtener información o sobre el cual se busca realizar inferencias. Una población puede ser finita, como el número de estudiantes en una institución, o conceptualmente infinita, como todos los posibles resultados de un experimento aleatorio.
¿Cuál es la diferencia fundamental entre una población y una muestra estadística?
La diferencia principal radica en la escala y la accesibilidad. Mientras que la población es el conjunto total de interés, la muestra es un subconjunto seleccionado de esa población para realizar observaciones prácticas. En la inferencia estadística, se utiliza la muestra para estimar parámetros poblacionales, asumiendo que, si la selección es representativa, las características de la muestra reflejarán con precisión las de la población. La relación entre el tamaño de la muestra y el de la población se denomina fracción de muestreo.
¿Cómo ha evolucionado el concepto de población en la historia de la estadística?
El desarrollo de este concepto comenzó a principios del siglo XVIII con pioneros como John Graunt, quien analizó datos demográficos, y Thomas Bayes, quien sentó las bases de la probabilidad. Durante el siglo XIX, figuras como Pierre-Simon Laplace y Carl Friedrich Gauss formalizaron la inferencia estadística. Posteriormente, en el siglo XX, investigadores como Ronald A. Fisher y Jerzy Neyman revolucionaron el campo al introducir teorías de muestreo rigurosas, permitiendo que el análisis de poblaciones se aplicara a disciplinas tan diversas como la economía, la medicina y las ciencias sociales.
¿Qué define a una media poblacional y por qué es importante?
La media poblacional, denotada comúnmente como μ, representa el valor esperado o la tendencia central de una distribución de probabilidad. Para una población finita, se calcula como la media aritmética de una propiedad específica en todos sus miembros. Es un parámetro crucial porque sirve como punto de referencia para evaluar la precisión de los estimadores muestrales. La ley de los grandes números garantiza que, a medida que el tamaño de la muestra aumenta, la media muestral tiende a aproximarse a la media poblacional.
¿Qué es una subpoblación y cómo afecta el análisis de datos?
Una subpoblación es un subconjunto de la población que posee propiedades adicionales distintivas. Identificar subpoblaciones es vital, ya que las estadísticas descriptivas pueden variar significativamente entre ellas. Si un análisis ignora estas divisiones, podría ocultar efectos importantes, como la respuesta diferenciada a un tratamiento médico. En modelos complejos, las poblaciones compuestas por subpoblaciones se estudian mediante modelos de mezcla para evitar sesgos en la interpretación de los datos.
¿Qué desafíos surgen al definir la población objetivo en las encuestas?
La población objetivo es el grupo de interés real, pero a menudo difiere de la población de muestreo debido a limitaciones prácticas. Factores como la falta de cobertura, donde ciertos individuos no pueden ser contactados, o la falta de respuesta, donde los individuos seleccionados deciden no participar, pueden introducir sesgos significativos. Los investigadores deben corregir estas discrepancias mediante métodos estadísticos para asegurar que los resultados sean representativos de la población que realmente pretenden estudiar.
¿Cuáles son las fuentes principales para el estudio de la población estadística?
- Feller, William (1950). Introduction to Probability Theory and its Applications, Vol I. Wiley.
- Yates, Daniel S., Moore, David S., & Starnes, Daren S. (2003). The Practice of Statistics. Freeman.
- Ross, Sheldon M. (2019). Introduction to Probability Models. Academic Press.
- Fisher, R. A. (1935). The Design of Experiments. Oliver & Boyd.
- Weisstein, Eric W. "Population". MathWorld. Wolfram Research.
Tu voto se guarda en este dispositivo.