
¿Qué es Unicode y cómo revolucionó la codificación de caracteres en la informática moderna?
Descubra qué es Unicode, su funcionamiento técnico, su historia y su importancia fundamental en el tratamiento de textos y sistemas informáticos globales.
En pocas palabras
- Unicode fue iniciado a finales de 1987 por ingenieros de Apple y Xerox para superar las limitaciones de los sistemas de codificación tradicionales.
- El Consorcio Unicode se constituyó formalmente en enero de 1991, publicando la primera versión del estándar ese mismo año.
- El espacio total de códigos de Unicode admite 1.114.112 posiciones distribuidas en varios planos normativos.
- Unicode mantiene un acuerdo histórico de sincronización con la Organización Internacional de Normalización (ISO/IEC) desde 1991.
¿Qué es Unicode y cómo revolucionó la codificación de caracteres en la informática moderna?
En este artículo exploraremos los fundamentos, la evolución histórica y el impacto técnico de Unicode, el estándar global diseñado para unificar la representación de textos en todos los idiomas del mundo y disciplinas técnicas.
¿Qué es exactamente Unicode y cuáles son sus objetivos principales?
Unicode es un estándar universal de codificación de caracteres que facilita el tratamiento informático, la transmisión y la visualización de textos procedentes de numerosos idiomas, alfabetos históricos y disciplinas técnicas. Su denominación surge de la combinación de tres metas fundamentales: universalidad, uniformidad y unicidad. El sistema asigna a cada carácter o símbolo un identificador numérico único denominado punto de código, acompañado de metadatos sobre su categoría, direccionalidad y propiedades tipográficas.
A diferencia de los esquemas tradicionales que presentaban limitaciones geográficas o de tamaño, Unicode trata de forma plenamente equivalente los caracteres alfabéticos, ideográficos y los símbolos matemáticos o musicales. Esto permite combinar distintos sistemas de escritura en un mismo documento sin necesidad de marcas o caracteres de control complejos.
Cómo se organiza el repertorio de caracteres y sus puntos de código?
El repertorio básico de Unicode se compone de grafemas definidos de forma abstracta, delegando la representación visual final a los programas informáticos y navegadores. El espacio total disponible para códigos abarca 1.114.112 posiciones, representadas habitualmente en notación hexadecimal con el prefijo U+ seguido de hasta seis dígitos. Para facilitar su organización interna, este espacio se divide en grandes grupos llamados planos, de los cuales el Plano Básico Multilingüe concentra la mayor parte de los alfabetos modernos y sistemas de escritura actuales.
Además de los caracteres gráficos visibles, el estándar define categorías específicas que incluyen caracteres de formato invisibles, códigos de control heredados por compatibilidad, áreas de uso privado para desarrolladores de software y rangos subrogados empleados por arquitecturas de codificación específicas.
De qué manera evolucionaron los ideogramas CJK y su unificación?
Los ideogramas de Asia oriental —conocidos popularmente como caracteres chinos y empleados en contextos de China, Japón, Corea y Vietnam— representan uno de los mayores volúmenes dentro del estándar. El organismo encargado de desarrollar esta sección es el Ideographic Rapporteur Group, que unificó las variantes nacionales bajo un mismo criterio abstracto, considerándolas diferencias tipográficas de un tronco común.
Esta inmensa colección de símbolos abarca desde los ideogramas de uso cotidiano en el Plano Básico hasta extensiones históricas muy poco frecuentes albergadas en planos suplementarios, complementadas con bases de datos auxiliares como Unihan que detallan significados y conversiones.
Cómo maneja Unicode la composición de caracteres y los signos diacríticos?
Para ampliar las opciones de representación sin multiplicar innecesariamente el número de códigos fijos, Unicode incorpora mecanismos avanzados de combinación. Un carácter base puede complementarse con marcas y signos diacríticos independientes para generar letras acentuadas o símbolos complejos.
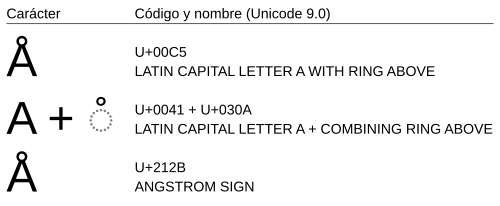
Adicionalmente, el estándar contempla formas precompuestas destinadas a garantizar la total compatibilidad con sistemas heredados, definiendo reglas estrictas de equivalencia canónica y de compatibilidad para normalizar cadenas de texto equivalentes.
Qué son y cómo funcionan las formas y esquemas de codificación UTF?
Los puntos de código abstractos definidos por Unicode deben traducirse en unidades binarias manejables por los procesadores mediante formas de codificación específicas. El estándar establece tres formatos principales denominados UTF: UTF-8, que emplea una longitud variable de uno a cuatro bytes optimizada para la compatibilidad con ASCII; UTF-16, optimizada para el Plano Básico Multilingüe; y UTF-32, que utiliza una longitud fija de 32 bits por carácter.
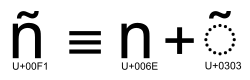
Asimismo, los esquemas de codificación determinan la serialización y el orden de los bytes en arquitecturas heterogéneas, haciendo uso opcional de marcas de orden de bytes cuando el protocolo de comunicación lo requiere.
Cómo se originó el proyecto y qué institución lo administra actualmente?
El desarrollo de Unicode comenzó a finales de 1987 gracias a las iniciativas de ingenieros como Joe Becker, Lee Collins y Mark Davis, quienes publicaron los primeros borradores conceptuales en 1988. Posteriormente, el 3 de enero de 1991, se constituyó formalmente el Consorcio Unicode como organización sin fines de lucro encargada de coordinar su evolución.
El Consorcio trabaja en estrecha colaboración con la Organización Internacional de Normalización, manteniendo una sincronización continua con el estándar ISO/IEC 10646 para asegurar que los puntos de código y los repertorios de caracteres permanezcan perfectamente alineados en las normativas internacionales de la industria tecnológica.
Sources & Further Reading
- The Unicode Consortium. Unicode 5.0 Standard. Addison-Wesley, 2006. Disponible en: http://www.unicode.org/versions/Unicode5.0.0/
- Unicode, Inc. Resumen histórico del estándar Unicode. Disponible en: http://www.unicode.org/history/summary.html
- Unicode, Inc. Acerca del estándar Unicode. Disponible en: http://www.unicode.org/standard/standard.html
Tu voto se guarda en este dispositivo.