
¿Qué es la web semántica y cómo transforma la información en Internet?
Descubre qué es la web semántica, sus orígenes, componentes principales como ontologías y metadatos, y cómo transforma los datos en Internet.
En pocas palabras
- La web semántica es una iniciativa del W3C para estructurar datos legibles por máquinas en Internet.
- Tim Berners-Lee propuso originalmente la inclusión de semántica en la World Wide Web y ha defendido su desarrollo continuo.
- Las tecnologías principales que sustentan la web semántica incluyen XML, RDF, OWL y SPARQL.
¿Qué es la web semántica y cómo transforma la información en Internet?
En este artículo se explican los conceptos fundamentales de la web semántica, sus antecedentes históricos, los componentes tecnológicos que la sustentan y los principales retos a los que se enfrenta en la actualidad para lograr que las máquinas comprendan el significado de los datos en la red.
¿Qué es exactamente la web semántica y cuál es su objetivo principal?
La web semántica, conocida en inglés como Semantic Web, es un conjunto de actividades e iniciativas impulsadas por el World Wide Web Consortium (W3C) para crear tecnologías que publiquen datos legibles por aplicaciones informáticas o máquinas. Su base consiste en añadir metadatos semánticos y ontológicos a la World Wide Web, cuyas páginas son tradicionalmente de naturaleza textual. Estas informaciones adicionales describen de manera formal el contenido, el significado y la relación entre los datos, permitiendo que los sistemas informáticos los procesen e interpreten de manera automática. El objetivo primordial es mejorar Internet mediante la ampliación de la interoperabilidad entre sistemas a través de agentes inteligentes, programas capaces de comprender el significado subyacente de la información y no meramente las palabras escritas.
¿Cuáles son los antecedentes históricos que condujeron al desarrollo de la web semántica?
El concepto de interconexión de información tiene sus raíces en mediados del siglo XX con las propuestas pioneras sobre hipertexto. En 1945, Vannevar Bush describió un sistema distribuido llamado Memex en un artículo publicado en The Atlantic Monthly, donde planteaba la consulta de archivos de texto e imagen vinculados mediante enlaces. Posteriormente, en la década de 1960, Theodor Nelson acuñó el término hipertexto para referirse a una escritura no secuencial, mientras que Douglas Engelbart desarrolló el sistema oN Line System para la navegación en red local. Tomando como base estos desarrollos, Tim Berners-Lee y Robert Cailliau presentaron en 1990 la primera propuesta de la World Wide Web en el CERN, basada en HTML, HTTP y URI. A finales de los años 90, el W3C comenzó a estructurar la idea de la web semántica para superar la ambigüedad y la falta de estructuración de contenidos de la web basada exclusivamente en lenguaje natural, formalizando estos postulados en un artículo publicado en Scientific American en 2001.
¿Qué papel desempeñan los metadatos y las ontologías en la arquitectura de la web semántica?
La arquitectura de la web semántica descansa sobre la descripción precisa del significado y su manipulación mediante lógica y motores de inferencia. Por un lado, los metadatos actúan como datos que describen otros datos, especificando las características de los recursos web de forma relativa según cada aplicación. Por otro lado, las ontologías proporcionan jerarquías de conceptos dotadas de atributos y relaciones que definen una terminología consensuada. Según la definición clásica de Tom Gruber de 1993, una ontología es una especificación explícita, formal, conceptualizada y compartida de un modelo abstracto. Estas estructuras permiten modelar entidades y reglas lógicas que las computadoras pueden interpretar sin ambigüedades.
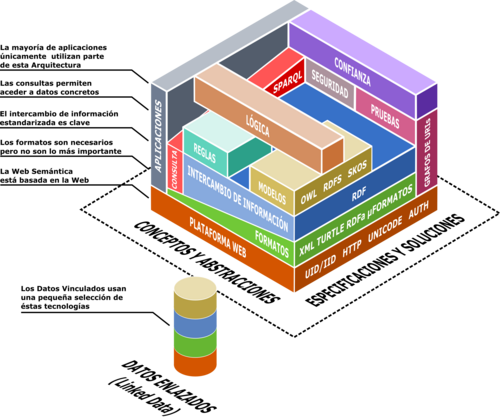
¿Cuáles son los componentes tecnológicos y metalenguajes utilizados en la web semántica?
El funcionamiento de la web semántica se apoya en una serie de estándares y metalenguajes desarrollados y normalizados por el W3C. Entre ellos destacan XML, que aporta la sintaxis superficial para documentos estructurados; XML Schema, utilizado para definir la estructura de dichos documentos; y RDF (Resource Description Framework), un modelo de datos elemental para describir recursos y sus interrelaciones. Asimismo, RDF Schema proporciona un vocabulario para estructurar jerarquías de clases y propiedades. Para la definición avanzada de ontologías se emplea OWL (Web Ontology Language), que permite modelar propiedades complejas, restricciones de cardinalidad y relaciones de equivalencia. Finalmente, SPARQL actúa como el lenguaje estándar de consulta para conjuntos de datos expresados en formato RDF.
¿Qué relación existe entre la web semántica y el concepto de Web 3.0?
Existe debate en la literatura académica y técnica acerca de las semejanzas y diferencias entre la web semántica y la Web 3.0. Mientras que algunos autores consideran que la web semántica constituye un componente o una parte integrante de la Web 3.0, el W3C suele emplear los términos web de datos y web semántica para referirse específicamente al ecosistema de datos enlazados y a las tecnologías semánticas que lo hacen operativo. El enfoque institucional del W3C se centra en conectar los datos que históricamente han permanecido aislados en silos dentro de la red, facilitando su integración y consulta automatizada a gran escala.
¿Cuáles son los principales retos técnicos y barreras para la adopción masiva de la web semántica?
A pesar de sus ventajas teóricas, la implantación a gran escala de la web semántica enfrenta múltiples obstáculos de carácter técnico y económico. Entre los desafíos técnicos señalados por la investigación destacan la inmensidad de la red, la indistinción o vaguedad de conceptos abstractos, la presencia de incertidumbre en los datos, la aparición de inconsistencias lógicas al combinar ontologías y la mitigación del engaño intencionado. Desde una perspectiva operativa, la principal barrera radica en el coste y la complejidad de convertir manualmente el vasto volumen de contenidos textuales de Internet a formatos semánticos como OWL, haciendo necesarios procesos de anotación automática o semiautomática. Además, los modelos de negocio basados en la publicidad tradicional en ocasiones disuaden a los editores de ceder sus datos estructurados directamente a agentes automáticos sin la visita directa de los usuarios.
Sources & Further Reading
- W3C Semantic Web Activity. World Wide Web Consortium. Disponible en: http://www.w3.org/2001/sw/
- Berners-Lee, Tim. Tejiendo la Red: el inventor del World Wide Web nos descubre su origen. Madrid: Siglo XXI de España Editores, 2000.
- Gruber, Tom R. Toward Principles for the Design of Ontologies Used for Knowledge Sharing. Stanford University, 1993.
- Pastor Sánchez, Juan Antonio. Tecnologías de la Web Semántica. Barcelona: Editorial UOC, 2011.
- Sikos, Leslie F. Mastering Structured Data on the Semantic Web: From HTML5 Microdata to Linked Open Data. Apress, 2015.
Tu voto se guarda en este dispositivo.